-
ComfyUI lokal als Bild-Provider: So habe ich Gemini rausgeschmissen und mir drei Edit-Workflows gebaut
ComfyUI lokal als Bild-Provider: So habe ich Gemini rausgeschmissen und mir drei Edit-Workflows gebaut Stell dir vor, du willst mal schnell ein Bild generieren. Ein Thumbnail, eine Grafik, ein Edit. Du tippst einen Prompt, klickst drauf — und schon läuft eine Sekunde lang ein Timer über deinem Bankkonto. Jede einzelne Generierung kostet Geld. Nicht viel,…
-
Ollama auf AMD GPU mit ROCm & Vulkan optimieren — Der komplette Guide

Warum das überhaupt ein Problem ist Du hast eine AMD Radeon RX 7900 XT oder W7800 im Rechner — 24 GB VRAM für das Preis-Leistungs-Verhältnis, das NVIDIA nicht bieten kann. Und Ollama? Läuft auf der CPU mit 10 tokens/s. Die GPU ist komplett untätig. Das war ich letztes Jahr auch. Jetzt läuft Qwen3.6:35B mit 71…
-
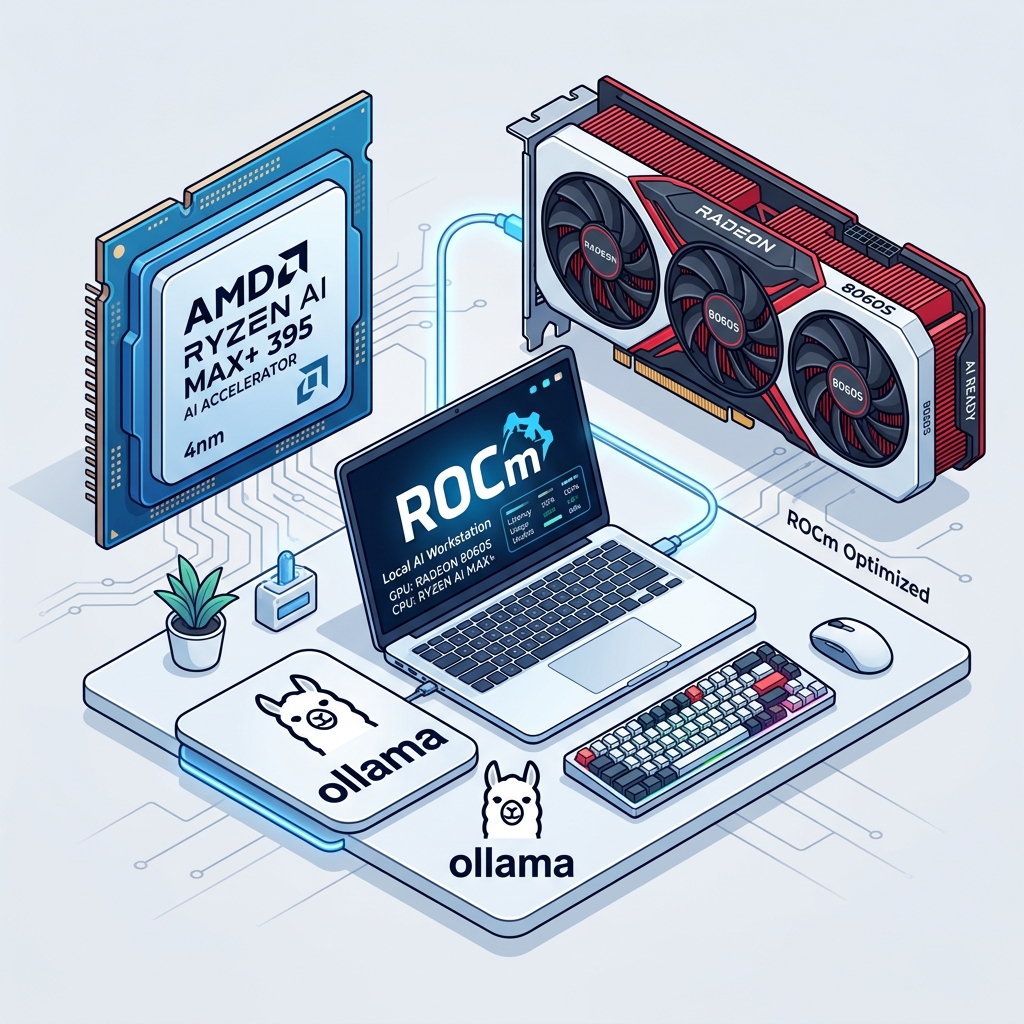
Meine OpenClaw-Installation: Hardware, ROCm, Ollama & PyTorch im Detail
-
Whisper large-v3-turbo auf GPU umgestellt — 807M params für bessere deutsche Transkription

Lerne OpenClaw mit Hanns